1 PFLOPS AI 算力、128 GB 内存和您的智能体。全部装进一台比魔方还矮的机身。
助手提供建议,智能体完成工作。
UniStudio 是随您的 M.RED Hive 一同提供的智能体工作台。您交给它一项任务,它便会打开文件、检索、撰写,并在您的工具中执行操作。任何有风险的操作前,它都会征求您的同意。
- 从安装到首个模型
- 1 次点击
- 个开箱即用的智能体角色
- 98
- 家模型提供方,本地或在线
- 24
开始使用
一键安装
UniStudio 检查内存和磁盘,安装模型引擎并下载适合您设备的模型。
提供您的文档
PDF、Word、Excel:在本地建立索引,并为每个回答标注来源。
设定限制
四个级别,从简单的行动方案到全自动。删除文件或发送邮件始终需要您的同意。
会执行的智能体
读写文件、在网上检索、启动程序、安排重复任务。
四级自主程度
由您决定它可以自主做到哪一步。
- 每次都询问
- 仅制定方案
- 确认修改
- 全自动
您的文档,附带来源
私有知识库:每条回答都会标明出处段落。
接入您的各种工具
通过 MCP 协议,它可在您已有的服务中开展工作。
- Gmail
- 日历
- Drive
- Notion
- GitHub
您不在时它照常工作
计划任务自动运行。需要您决定的事项会留在收件箱中等待。
整机尽在掌控
实时掌握处理器、GPU 和内存状态,并提供性能与风扇模式。
您在睡觉,您的 AI 仍在推进。
- 09:00
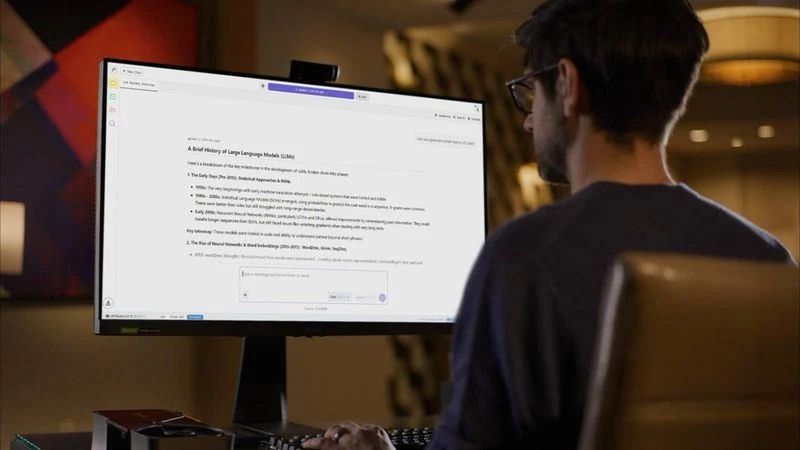
您到岗,它已开工。
您的智能体已整理好邮箱、归类了前一天的文件,并准备好在办事项的进展汇总。
智能体 · 邮件与文件 - 14:00
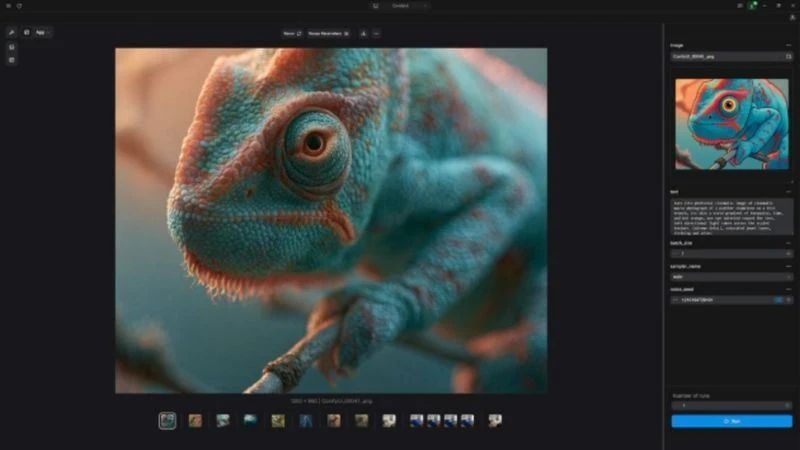
您创作,它同时运算。
批量生成图像、4K 视频预览、后台 3D 渲染:无需在云端排队。
创作 · 图像与视频 - 19:00
您下班,它接手。
它为您的文档建立索引,方便明天检索,或启动一次长时间的视频生成。
计划任务 - 03:00
您在睡觉,它在值守。
芯片最高 140 W,静音运行。需要您确认的事项,会在 UniStudio 的收件箱里等您回来。
待机 · 最高 140 W
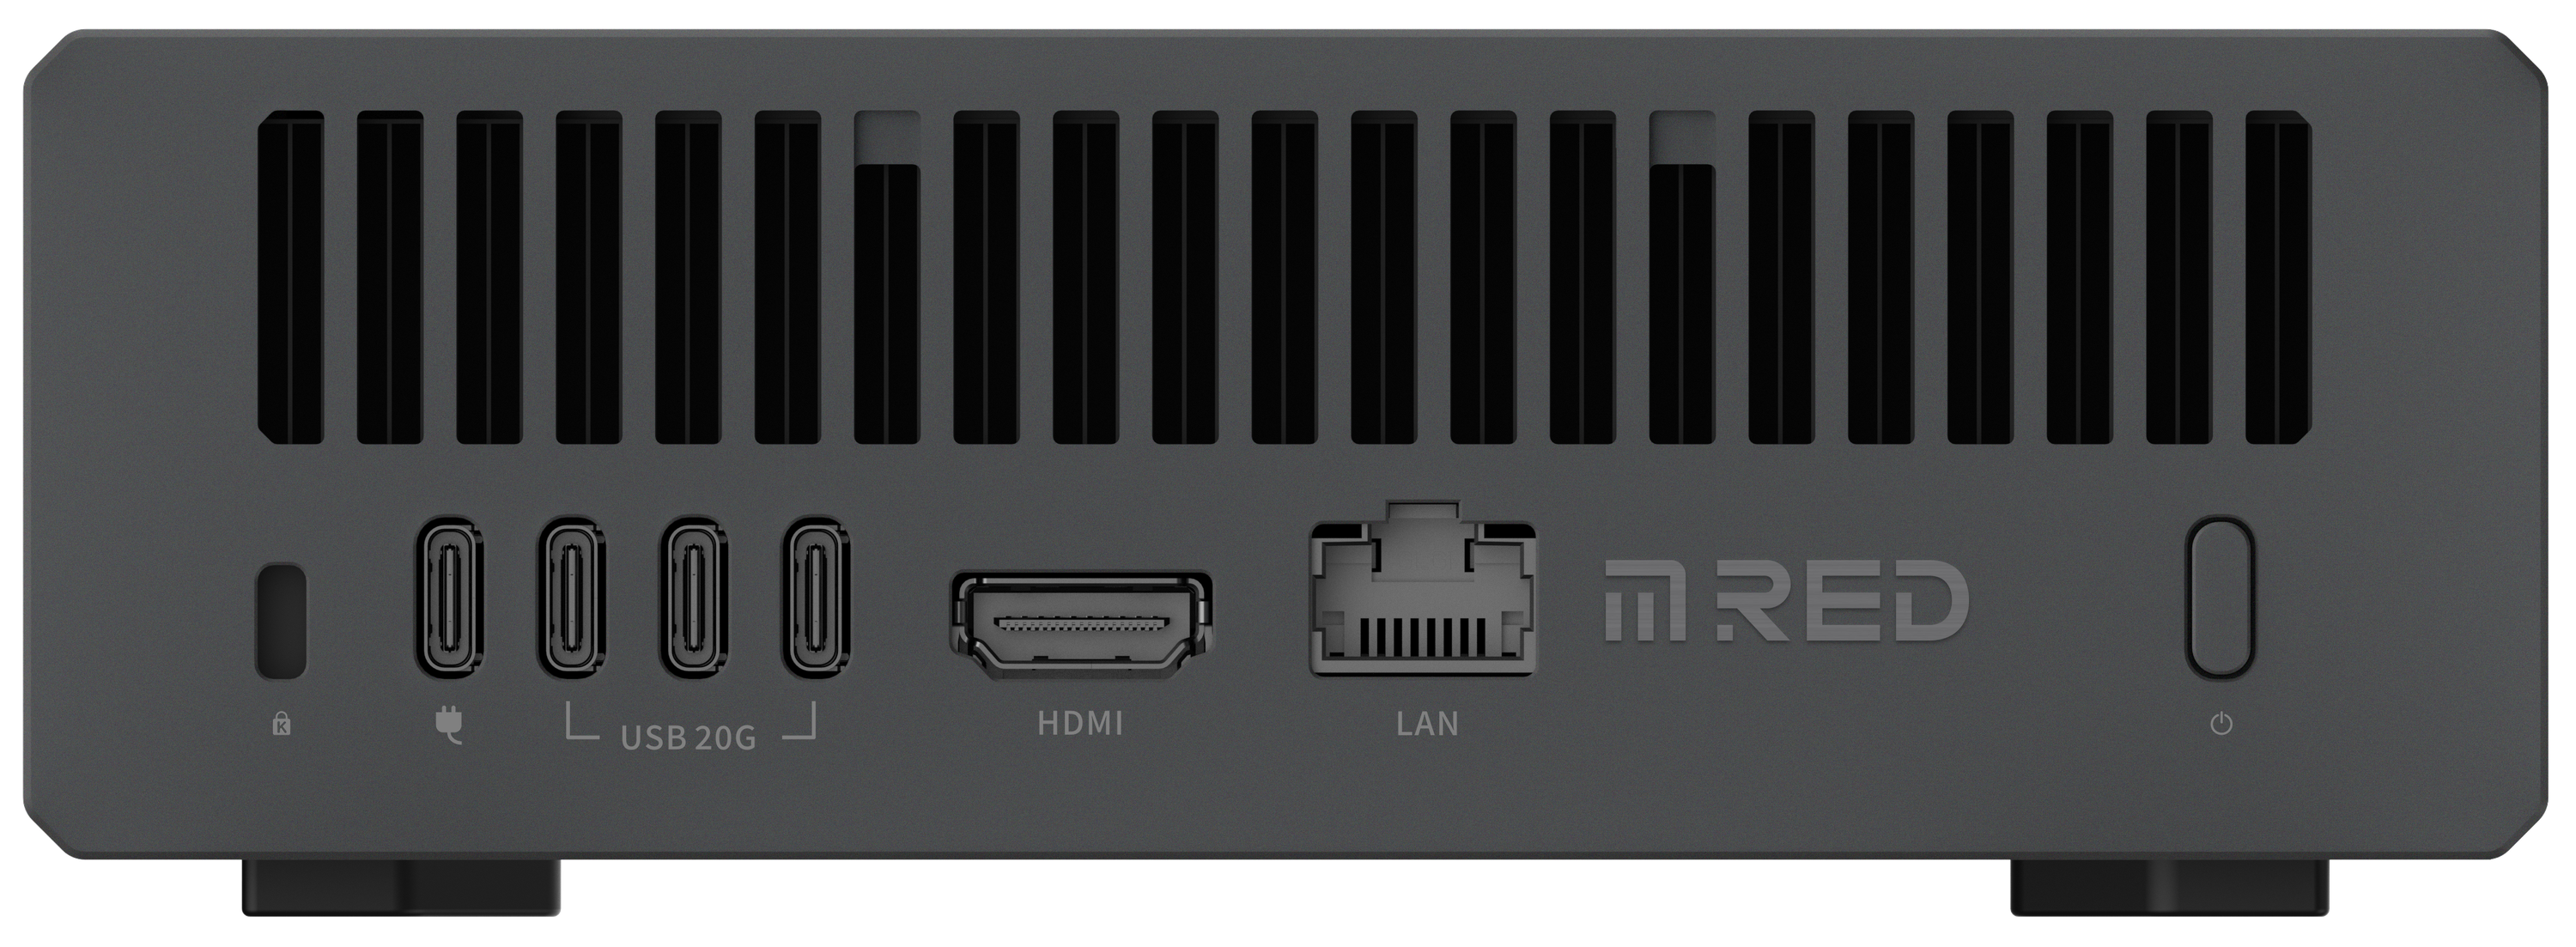
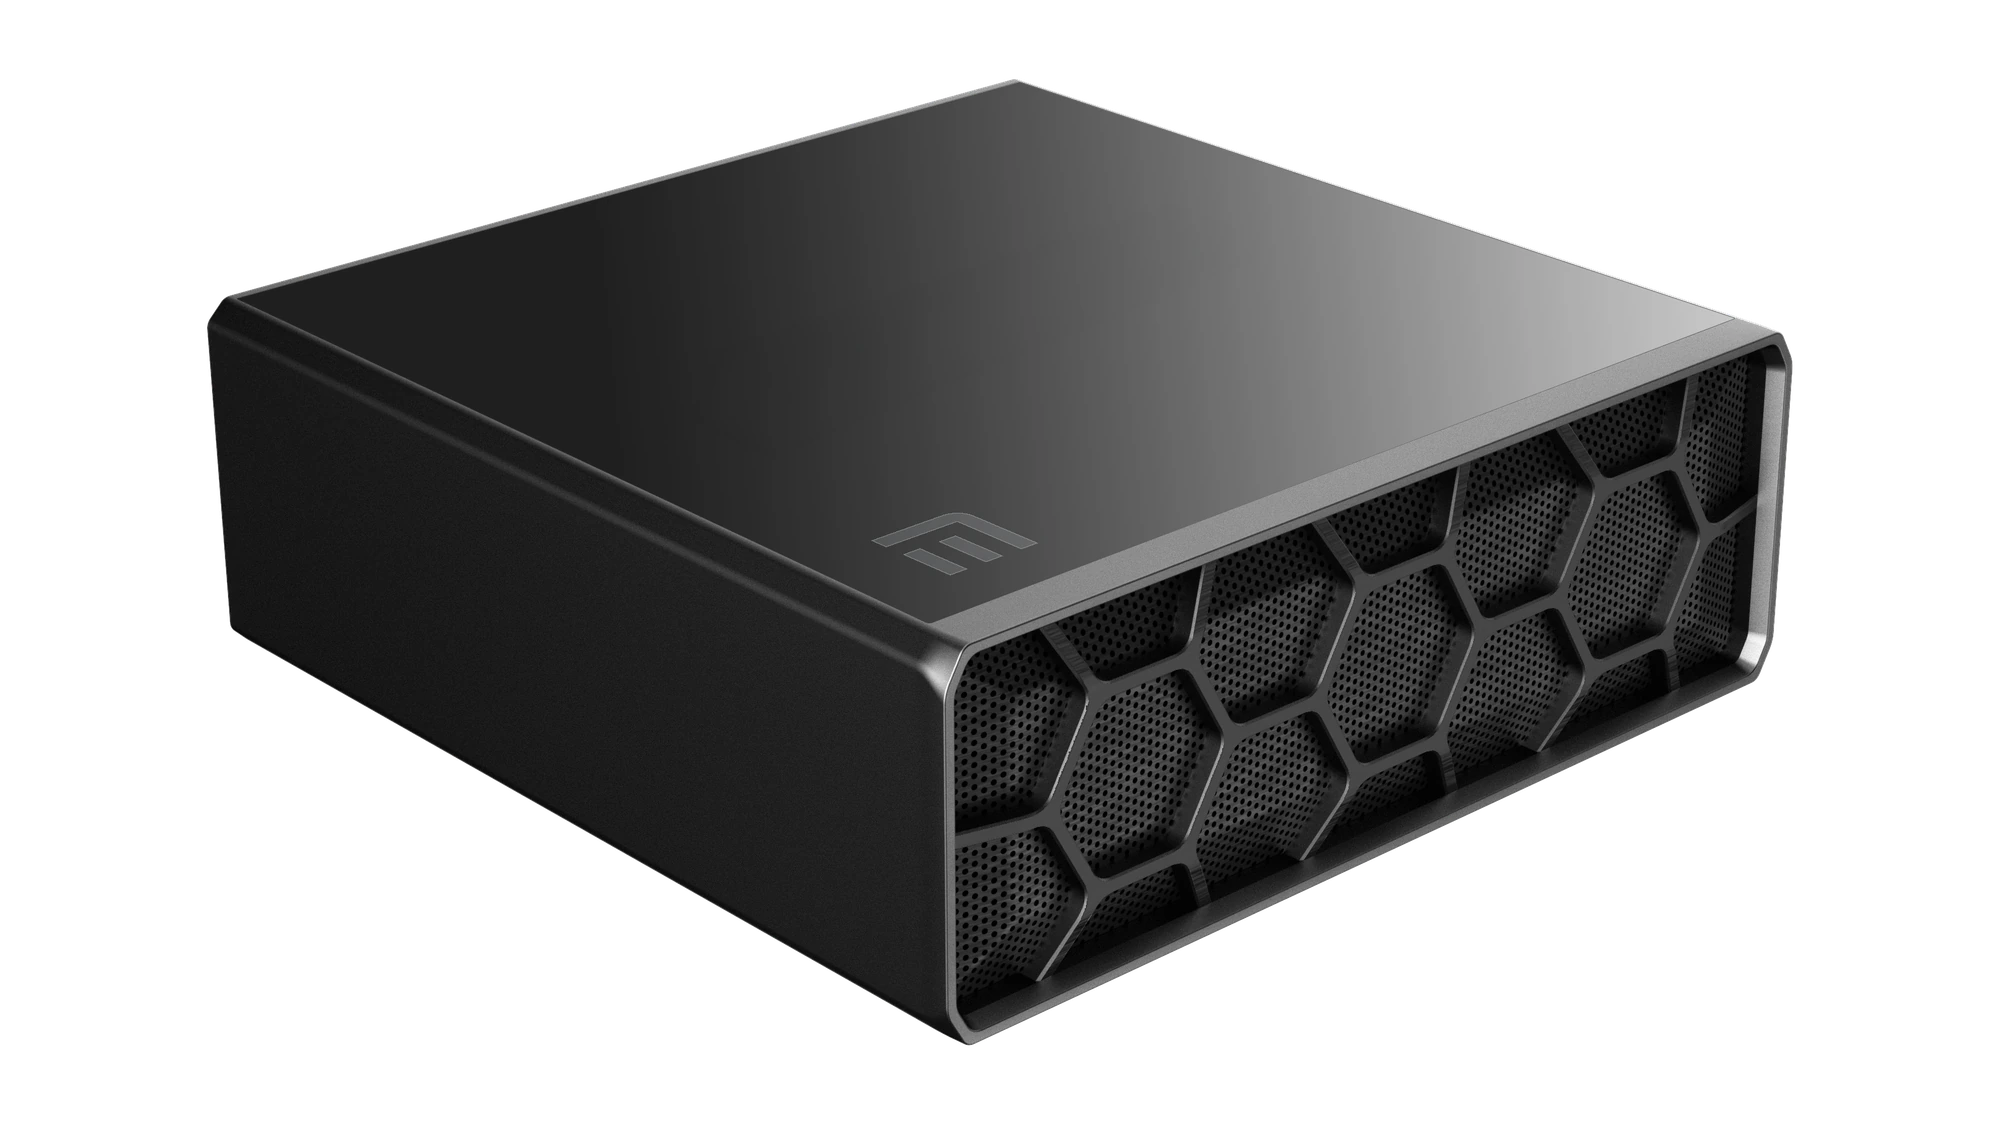
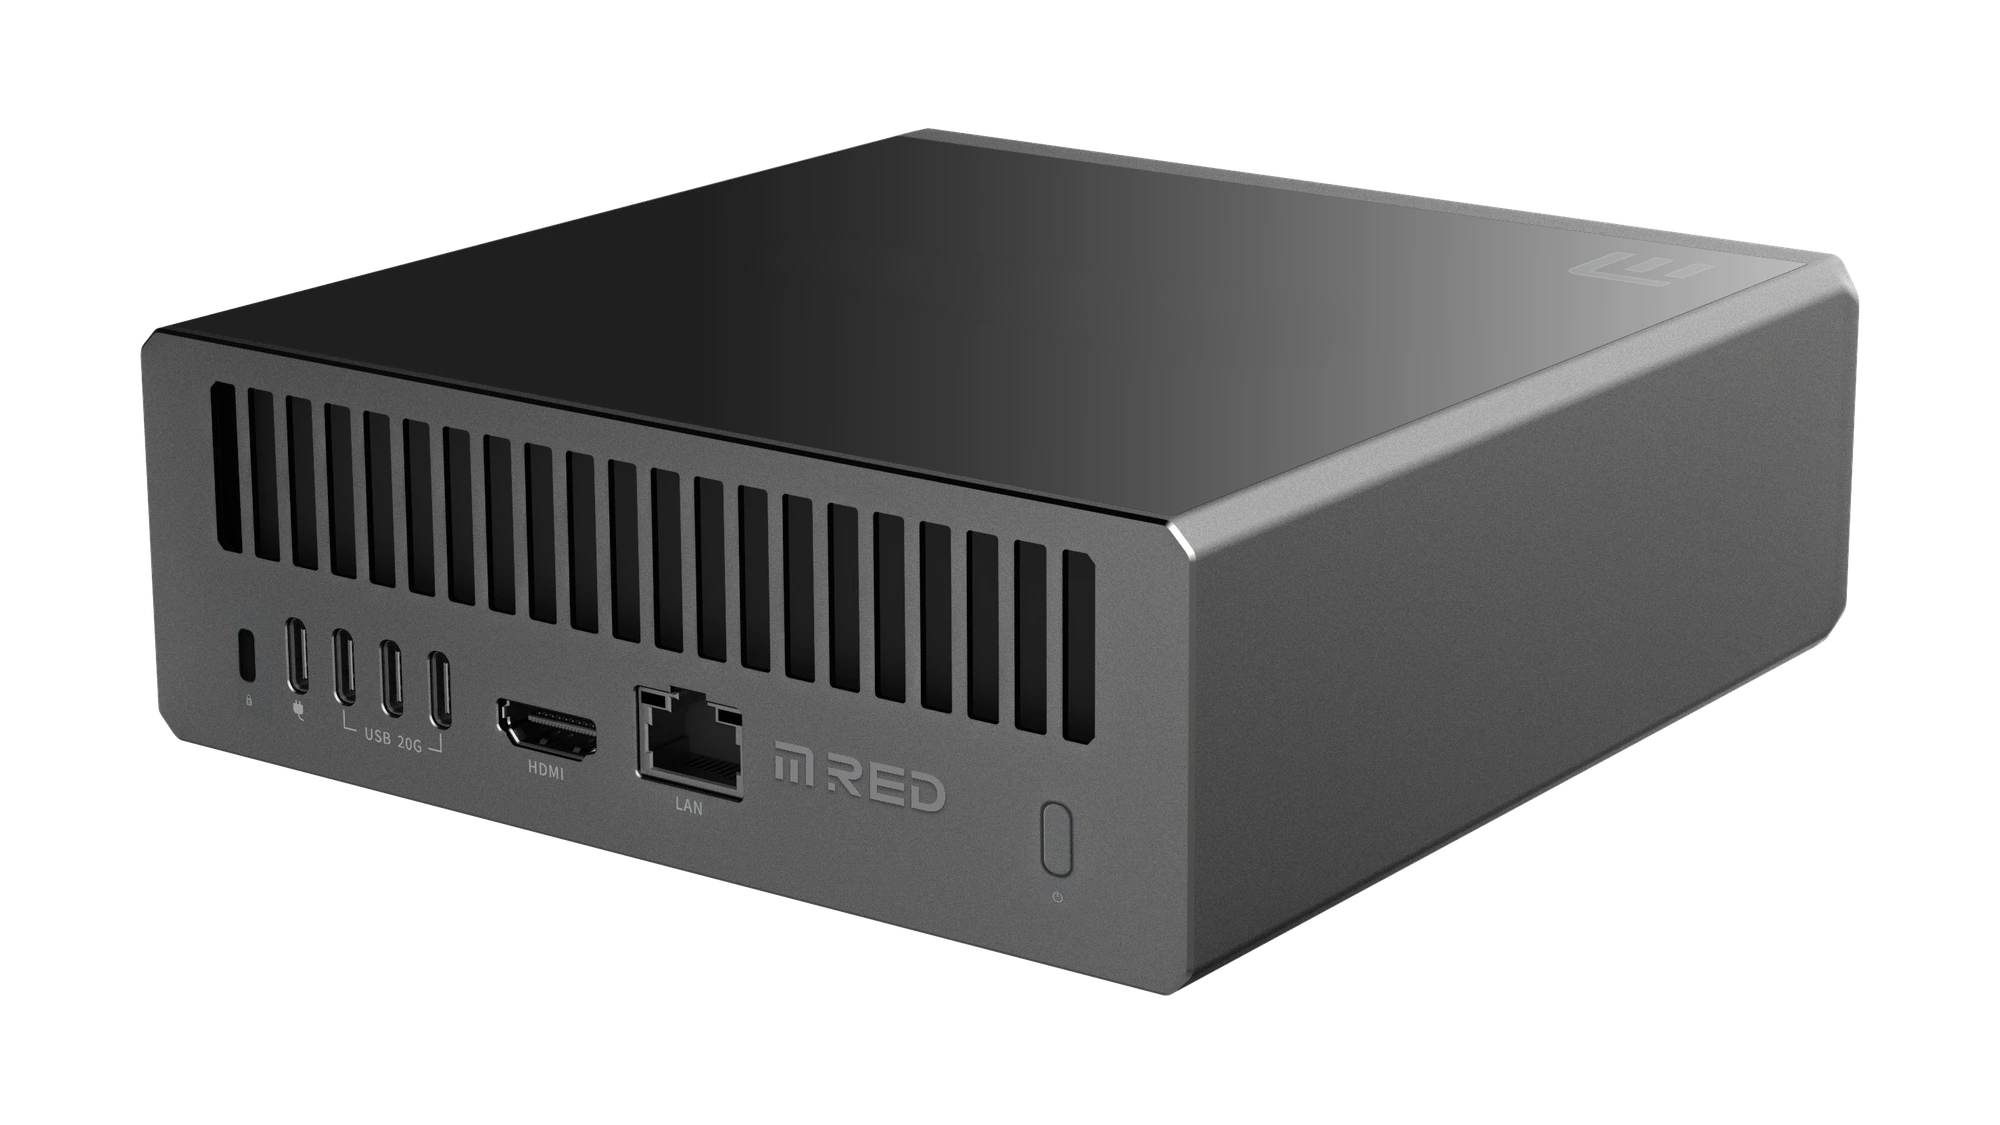
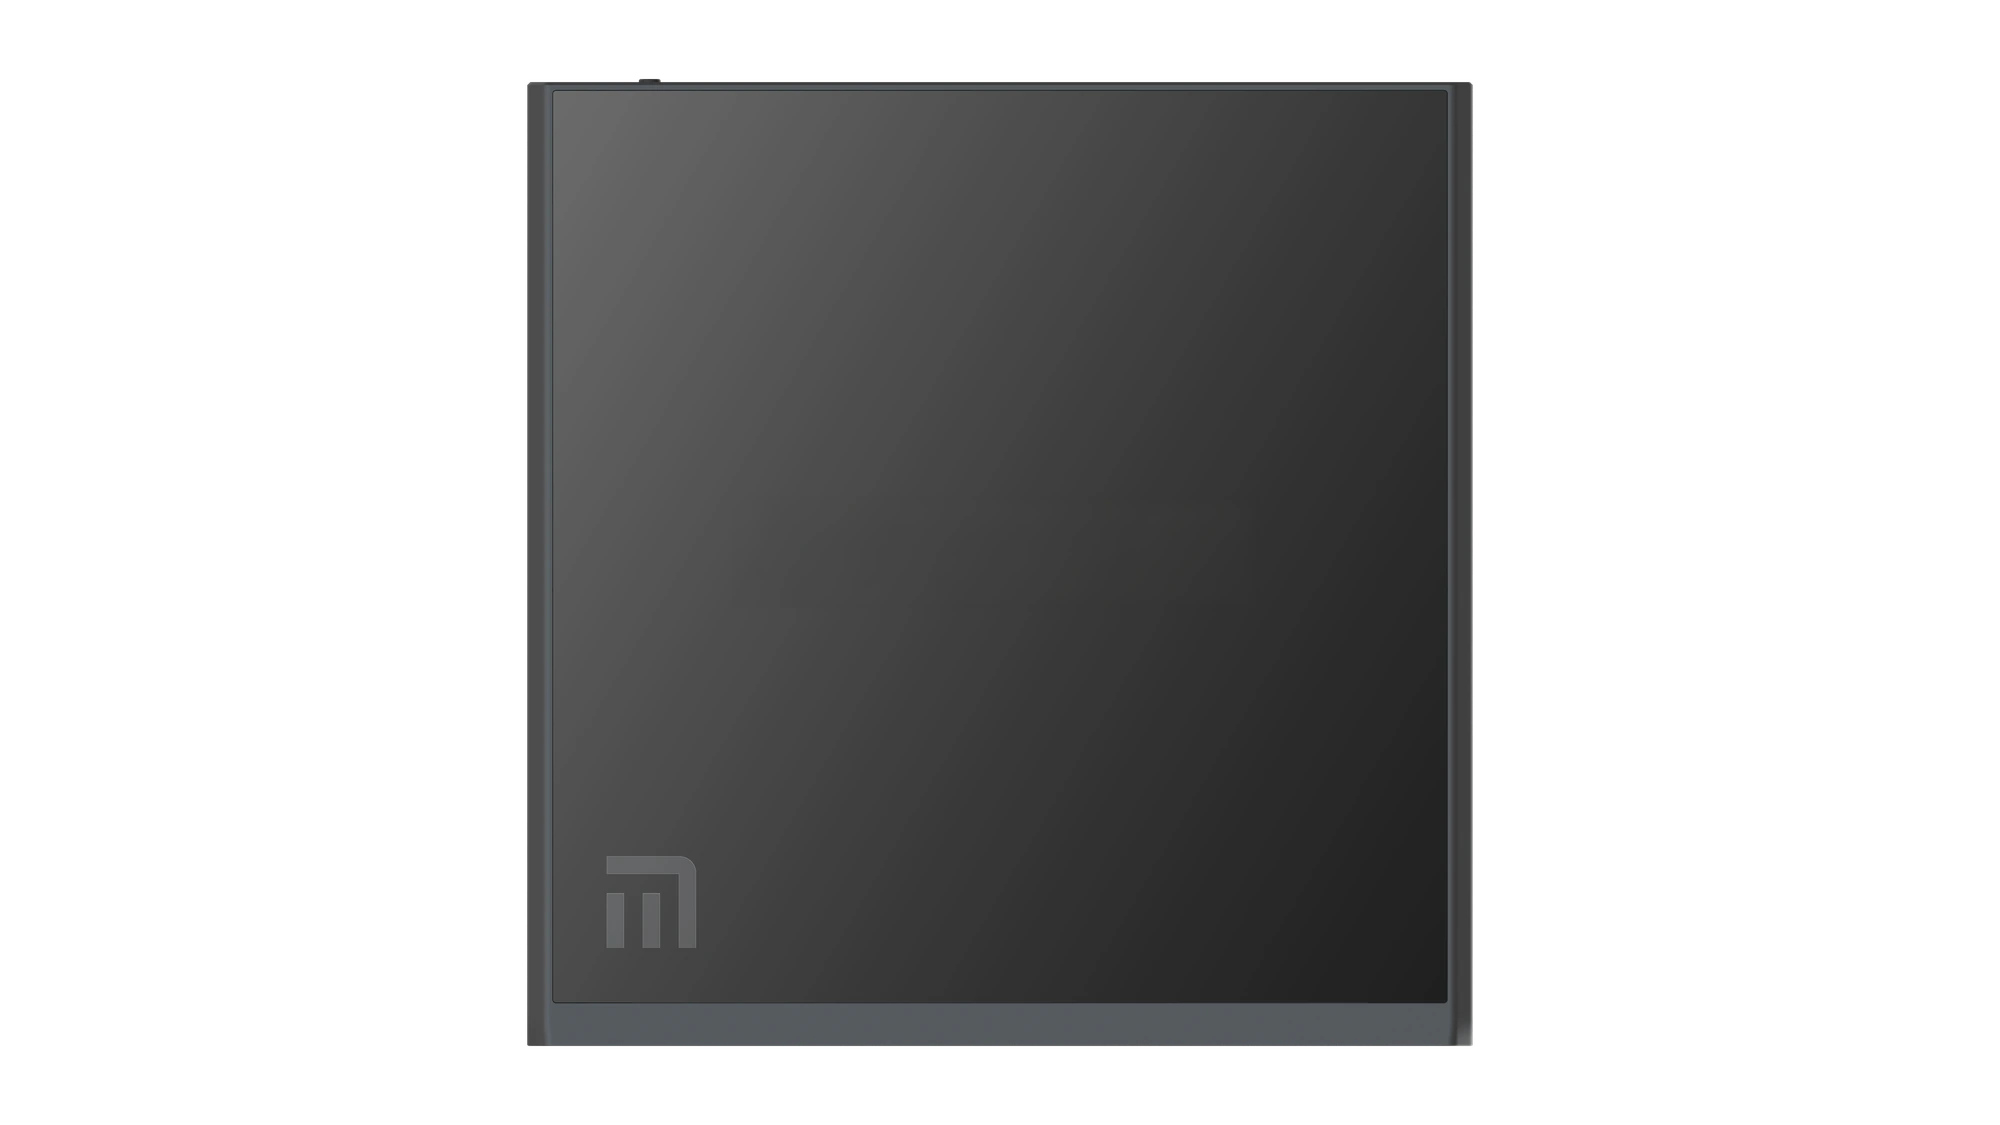
比魔方还矮。
边长 15.5 cm,高 5.1 cm,重 1.42 kg。铝合金外壳,顶部为防指纹处理玻璃,正面为蜂巢纹金属网,系列名称正由此而来。所有接口均位于背面。
一台传统游戏塔式机箱要占用约三十倍的空间。
配置您的 M.RED Hive。
四种选择。内存需在购买时决定:它已焊接在芯片上。
全部细节。
- 处理器NVIDIA Grace,20 个 Arm 核心
- 显卡NVIDIA Blackwell RTX,6 144 个 CUDA 核心
- AI 性能FP4 算力达 1 petaflop(1)
- 内存64 或 128 GB LPDDR5X 统一内存9 400 MT/s,板载
- 功率芯片功耗 140 W
- 系统Windows 11(版本 26H1)
- 安全专用 TPM 芯片,Nano 防盗锁孔
- 存储1 个 M.2 2280 NVMe PCIe x4 插槽
- 网络10 GbE 以太网、Wi-Fi 7 和蓝牙
- 视频输出1 × HDMI 2.1b,3 × USB-C DisplayPort 1.4a
- 供电USB-C 电源适配器 240 W,100 至 240 V
- 尺寸155 × 158 × 51 mm
- 重量1,42 kg
- 材质铝材、金属网、防指纹玻璃
来源:NVIDIA RTX Spark 规格(桌面版)及厂商资料表。
- AI 算力 AI 算力FP4 下每秒一千万亿次运算(1):昔日需要一台服务器才能完成的工作,如今在家即可实现。
- 1 PFLOPS
- 统一内存 统一内存处理器与显卡共享同一池内存。大模型可完整载入其中。
- 128 GB
- 处理器 处理器NVIDIA Grace,源自数据中心的 Arm 架构。
- 20 核心
- 图形 图形CUDA Blackwell,配备第 5 代 Tensor Cores 与第 4 代 RT Cores。
- 6 144 核心
- 功耗 功耗这是芯片的最高功耗:低于一块高端游戏显卡。
- 140 W
- 本地模型 本地模型128 GB 下最高可达的参数量:与在线服务同等规模的模型,就在您的桌面上(2)。
- 2000 亿
两颗大脑,一颗芯片。
在传统 PC 中,处理器与显卡通过主板通信。RTX Spark 把两者集成在同一颗芯片上,共享同一份内存。
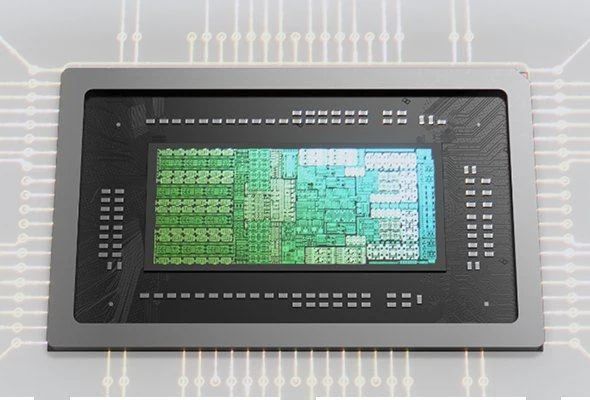
内存更大,模型更大。
AI 模型以数十亿参数来衡量。参数越多,推理越细致,所需内存也越多。选择一个规模,看看它能做什么。
24GB32GB48GB64GB128GB
- 最大本地模型
- 120 亿参数250 亿参数600 亿参数900 亿参数2000 亿参数
- 智能体
- 云端云端本地本地进阶,本地
- 3D 场景
- 可交互可交互可交互最高 45 GB最高 90 GB
NVIDIA 针对量化模型给出的参考值(2)。内存与 Windows 及您的应用共享。Hive 系列分为 Hive 64 和 Hive 128。
8B
日常对话提问、改写、快速翻译。
32B
撰写与总结会议纪要、长文档摘要。
70B
编程与分析开发助手、数据分析。
120B
像前沿模型一样推理最高一百万 token 上下文:一次读完整个卷宗(3)。
200B
多个智能体并行运行最大的模型,同时其他智能体继续工作。
量级参考。实际能力取决于量化方式和上下文长度。
同样的 AI,两种去处。
| 云端 AI | 技术参数 | M.RED Hive |
|---|---|---|
| 每个问题都要经过互联网并排队等待。 | 响应 | 即时响应,不依赖网络。 |
| 您的文档被传送到第三方服务器。 | 隐私 | 数据不外传:始终留在这间屋子里。 |
| 按人头订阅,有时还按问题计费。 | 成本 | 一次购买,调用不再计费。 |
| 模型由服务商决定何时更换。 | 掌控 | 由您选择模型,以及何时更换。 |
| 网络中断,助手即停。 | 离线 | 没有网络也能继续运行。 |
您也可以选择让 UniStudio 调用在线模型:决定权在您手中。
本地 AI 如何改变您的一天。
画面、光效、镜头角度:尝试、保留、再来一次,无需排队等待。
概念设计探索
手绘草图,或在云端排队:每张图要等上数十秒,有时是几分钟。
构思的同时画面即刻呈现。重新布光或更换背景,试多少次都可以。
视频剪辑
多加一个机位或一层特效,就意味着逐帧修改或漫长渲染。
多机位与特效在 4K 预览中叠加呈现。摄影机的 4:2:2 由硬件解码。
比较、压缩、测量:全部在本机完成,不受配额限制。
并行调参
云端配额限制下,只能一次调一组参数,分多个会话完成。
多个版本同时运行,指标并排对照。过拟合一目了然。
模型量化
每试一次压缩,都要重新上传模型才能测出精度损失。
在本地从 FP16 到 INT4:快速找到速度与精度的最佳平衡点。
各种格式的文档,在本地完成比对核账。
账目核对
ERP、库存与银行流水逐行比对:科目归类出错、付款重复。
AI 读取文档,比对各系统数据,逐一锁定差异。
压力测试
汇率、原材料与付款延迟同时纳入:电子表格直接卡死。
基于历史数据进行模拟,生成可直接呈交管理层的报告。
合同不经过任何第三方服务器。
合同审阅
一条含糊的条款或缺失的责任上限,老手也要花上数小时。
精细比对,标出风险条款与前后矛盾之处。
庭审准备
预判对方论点只能依靠合伙人的经验。
基于判例进行模拟推演,让整个团队做好准备。
健康数据始终留在本地。
影像
阅读 CT 与核磁影像,每份报告要耗去半天,还要承受视觉疲劳。
在问诊过程中完成辅助比对与 3D 重建,为医生提供支持。
药物相互作用
说明书只能逐份核对,罕见的联用组合容易被遗漏。
病史与诊断交叉比对,开具处方时即刻提示预警。
一次购买,无需按工位订阅。
跨部门分析
ERP、CRM 与物流数据由各部门各自汇总,结果总是滞后。
各类数据源在本地汇总,瓶颈即刻显现。
在您的档案中检索
多年积累的程序文件与项目资料散落各处,又过于敏感,不宜上云。
离线检索,并引用您自己的文档作答。
仅为示例场景。医疗与法律用途仍由专业人士自行负责。
您的软件,由 RTX 加速。
Windows 11 下的 Arm 处理器
Arm 应用和 CUDA 软件栈原生运行。x86 软件则通过 Windows 模拟运行:购买前请确认您的专业软件和外设驱动。
AI 智能体具体是什么?
助手负责回答。智能体则负责行动:您给它一个目标(「根据我的邮件准备周一的汇报」),它会拆解任务、打开所需文件、使用您的工具,并把结果交给您。在 UniStudio 中,任何有风险的操作前,它都会先征求您的同意。
我的软件能在这台 PC 上运行吗?
Windows 11、Arm 应用和 CUDA 堆栈均原生运行。x86 软件通过 Windows 内置模拟运行。部分旧版工具、行业软件或设备驱动可能无法工作:购买前请列出清单,我们的支持团队会协助您核实。
64 还是 128 GB?
64 GB 足以支持一个常驻智能体以及最高 900 亿参数的模型。128 GB 则可运行前沿模型并同时运行多个智能体。内存为板载焊接,需在购买时选定。
与配备 RTX 5090 的 PC 有何区别?
RTX 5090 塔式机箱在游戏与渲染上拥有更强的原始算力,配备 32 GB 显存。RTX Spark SFF 则在处理器与 GPU 之间共享最高 128 GB:它能运行大得多的 AI 模型,机身比游戏塔式机箱小三十倍左右,芯片功耗为 140 W。
那 NVIDIA 的 DGX Spark 呢?
DGX Spark 运行 Linux(DGX OS),面向训练和微调模型的开发者。M.RED Hive 运行 Windows 11:保留您的创作软件、游戏和办公工具。
噪音大吗?
芯片功耗限制在 140 W,因而散热紧凑而安静。UniStudio 提供多种风扇模式,从静音到涡轮。
需要连接互联网吗?
安装和下载模型时需要。之后,本地模型和您的文档均可离线使用。
注释
(1)FP4 稀疏 AI 性能,数据来自 NVIDIA;(2)按内存容量划分的模型规模参考:NVIDIA“帮我选择”页面(量化模型);(3)支持最高 1200 亿参数模型、100 万 token 上下文,数据来自 NVIDIA;(4)视所用显示器和线缆而定;(5)支持 NVIDIA CUDA 12.1、TensorRT 与 NVFP4,依据 NVIDIA RTX Spark 规格;(6)依据 NVIDIA“帮我选择”页面(性能因游戏和设置而异)。
资料来源。 NVIDIA RTX Spark N1X(桌面版)规格及厂商资料,2026 年 11 月。NVIDIA、RTX、GeForce、CUDA、DLSS、G-SYNC 和 Blackwell 均为 NVIDIA Corporation 的商标。NVIDIA 图片经授权使用。配置器显示的金额仅供参考。