La IA de vanguardia, en su escritorio.
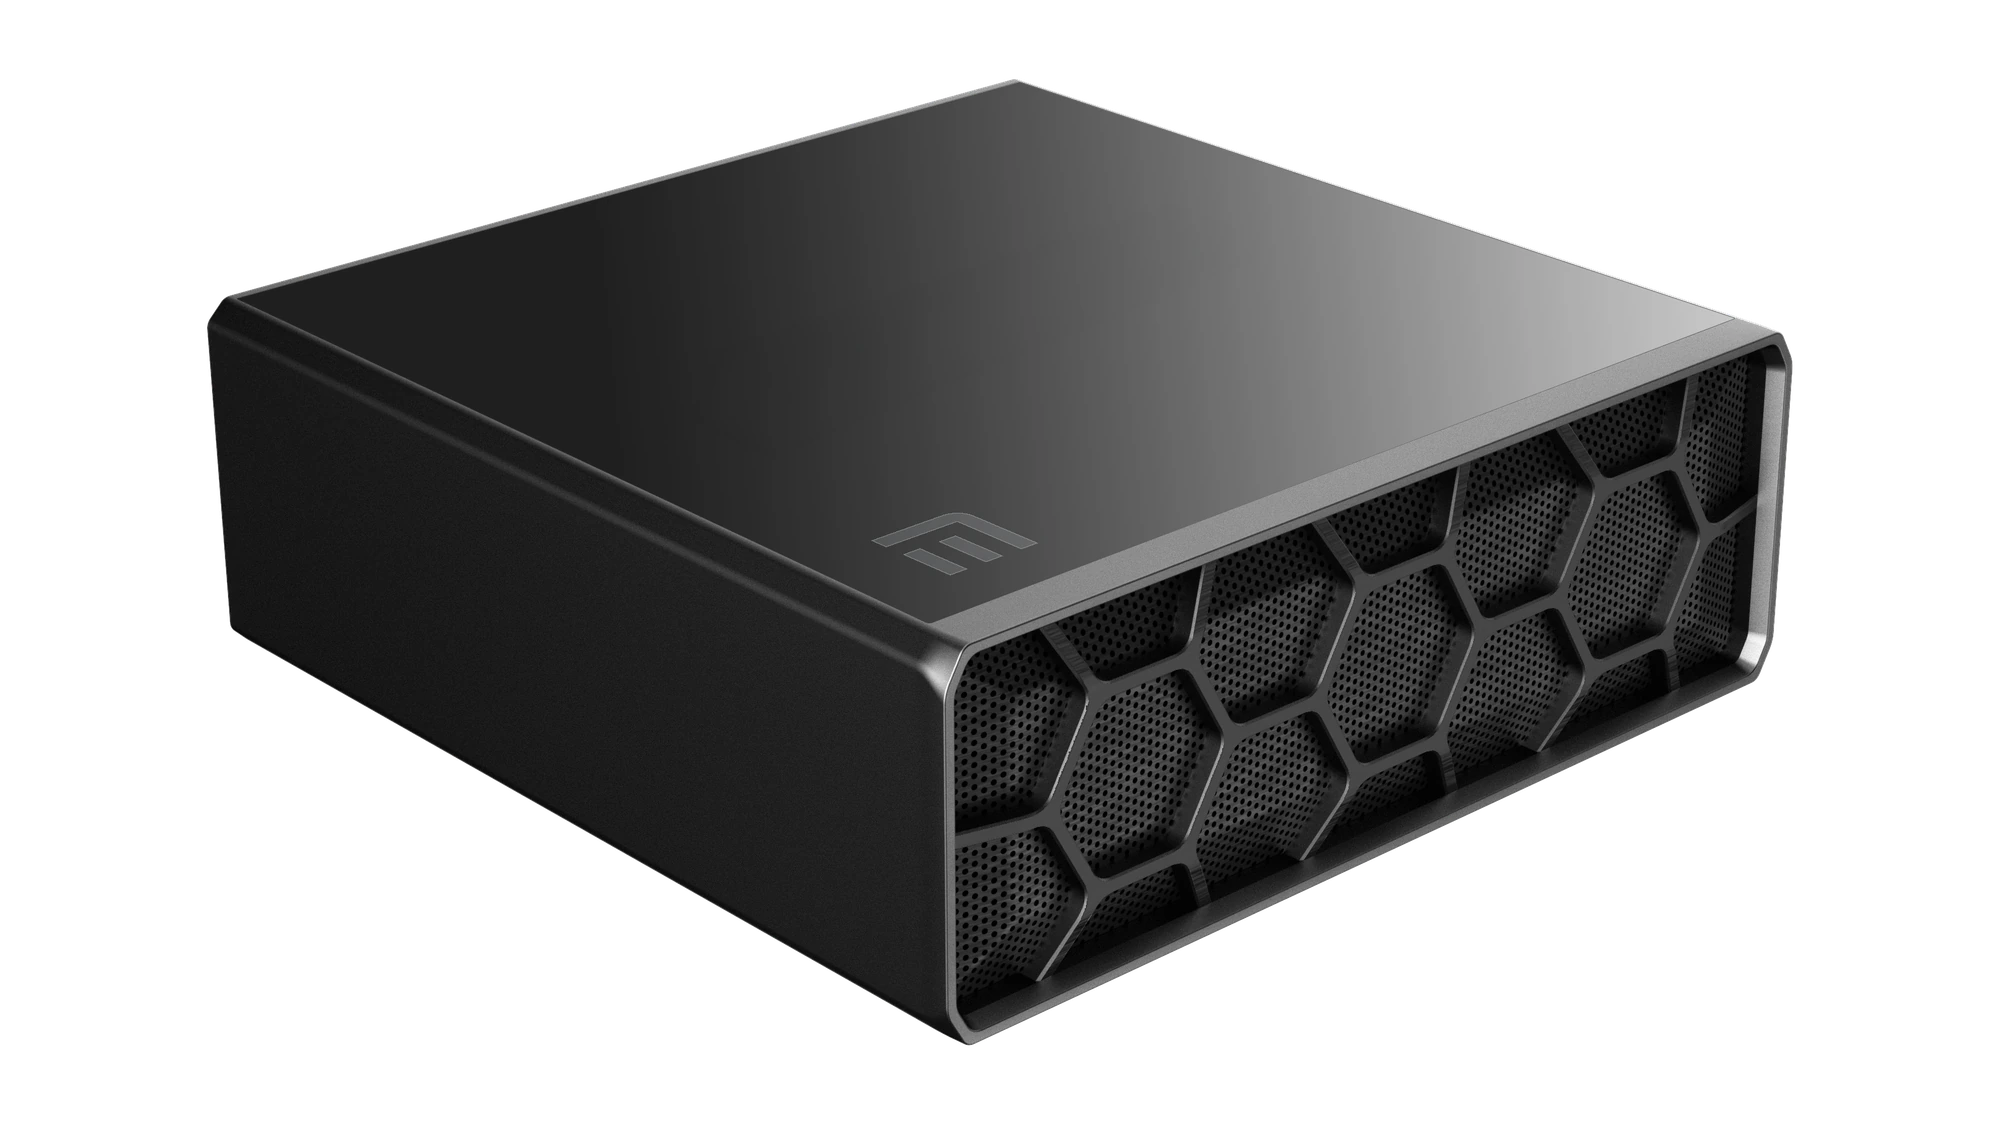
Un petaflop de IA, 128 GB de memoria y sus agentes. Todo en una caja más baja que un cubo de Rubik.
Un asistente aconseja. Un agente trabaja.
UniStudio es el taller de agentes que se incluye con su M.RED Hive. Usted le encarga una tarea y él abre los archivos, busca, redacta y actúa en sus herramientas. Le pide su consentimiento antes de cualquier acción arriesgada.
- de la instalación al primer modelo
- 1 clic
- roles de agentes listos para usar
- 98
- proveedores de modelos, locales o en línea
- 24
La puesta en marcha
Instalar con un clic
UniStudio comprueba la memoria y el disco, instala el motor de modelos y descarga los que se adaptan a su máquina.
Aportar sus documentos
PDF, Word, Excel: los indexa en local y cita la fuente de cada respuesta.
Fijar los límites
Cuatro niveles, desde el simple plan de acción hasta el automático. Borrar un archivo o enviar un correo siempre requiere su aprobación.
Agentes que actúan
Leer y escribir archivos, buscar en la Web, ejecutar un programa, programar una tarea recurrente.
Cuatro niveles de autonomía
Usted decide hasta dónde llega por sí solo.
- Preguntar siempre
- Solo el plan
- Validar las modificaciones
- Automático
Sus documentos, con sus fuentes
Una base de conocimientos privada: cada respuesta indica el pasaje del que procede.
Conectado a sus herramientas
Mediante el protocolo MCP, trabaja en los servicios que ya utiliza.
- Gmail
- Calendario
- Drive
- Notion
- GitHub
Trabaja en su ausencia
Las tareas programadas se ejecutan solas. Lo que requiere su decisión espera en la bandeja de entrada.
La máquina bajo control
Procesador, GPU y memoria en directo, con modos de rendimiento y de ventilación.
Su IA avanza mientras usted duerme.
- 09:00
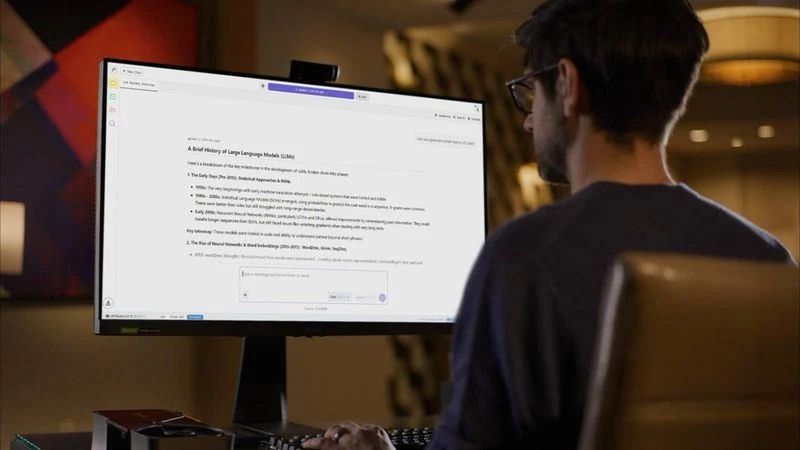
Usted llega, él ya ha trabajado.
Su agente ha ordenado el buzón, clasificado los archivos del día anterior y preparado el resumen de sus proyectos en curso.
Agente · correos y archivos - 14:00
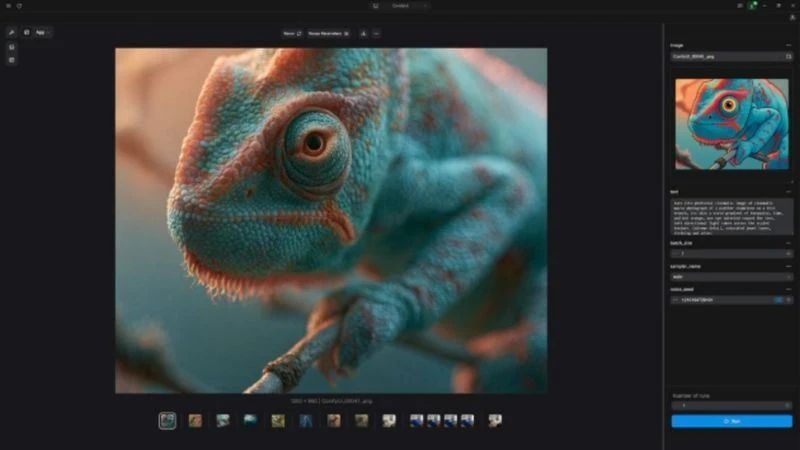
Usted crea, él calcula en paralelo.
Generación de imágenes en serie, previsualizaciones de vídeo en 4K, renderizado 3D en segundo plano: sin cola de espera en la nube.
Creación · imágenes y vídeo - 19:00
Usted se va, él toma el relevo.
Indexa sus documentos para poder consultarlos mañana, o lanza una generación de vídeo larga.
Tareas programadas - 03:00
Usted duerme, él vela.
140 W como máximo para el chip, en silencio. Lo que requiere su aprobación espera su vuelta en la bandeja de entrada de UniStudio.
Reposo · 140 W como máximo
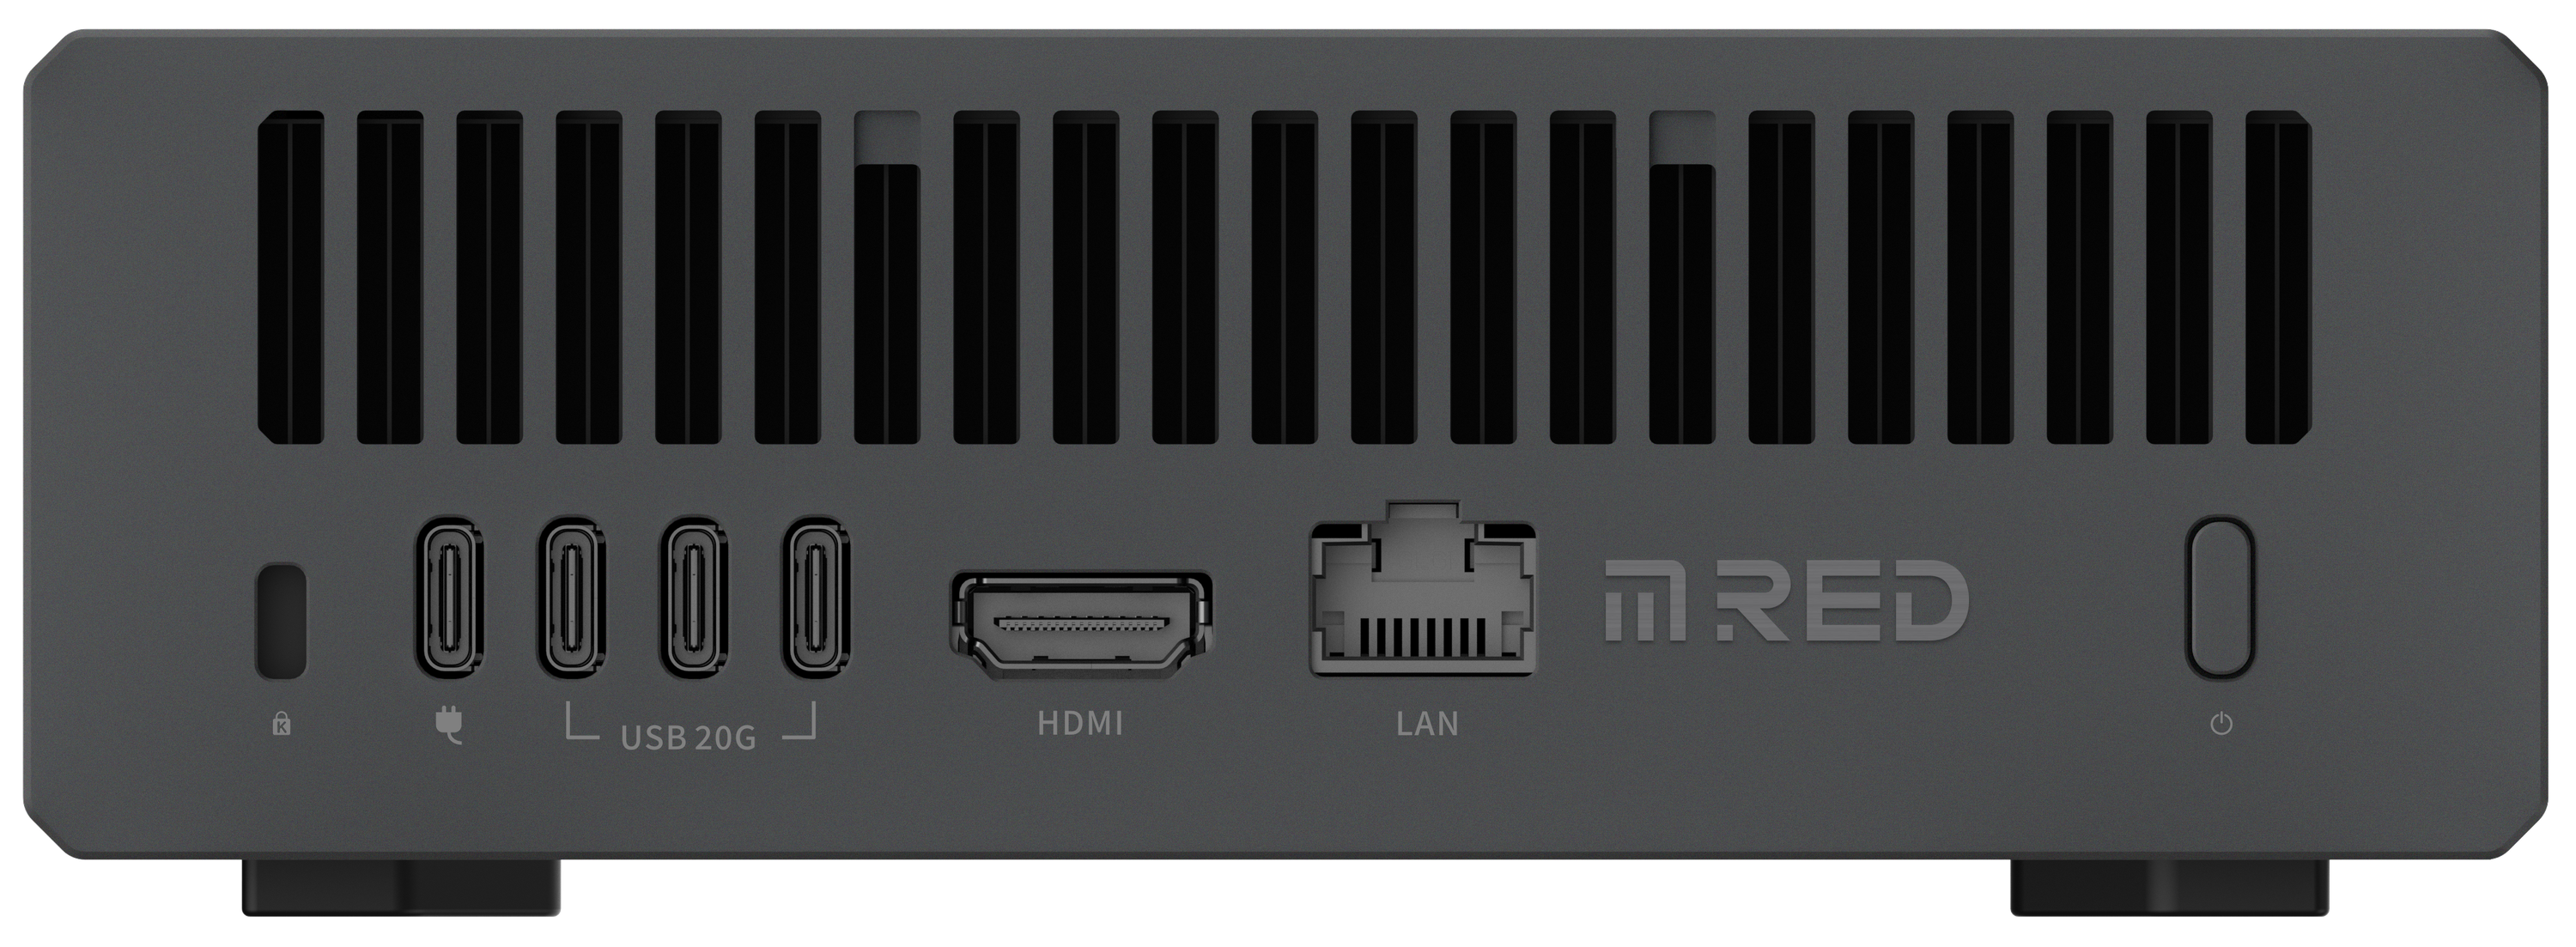
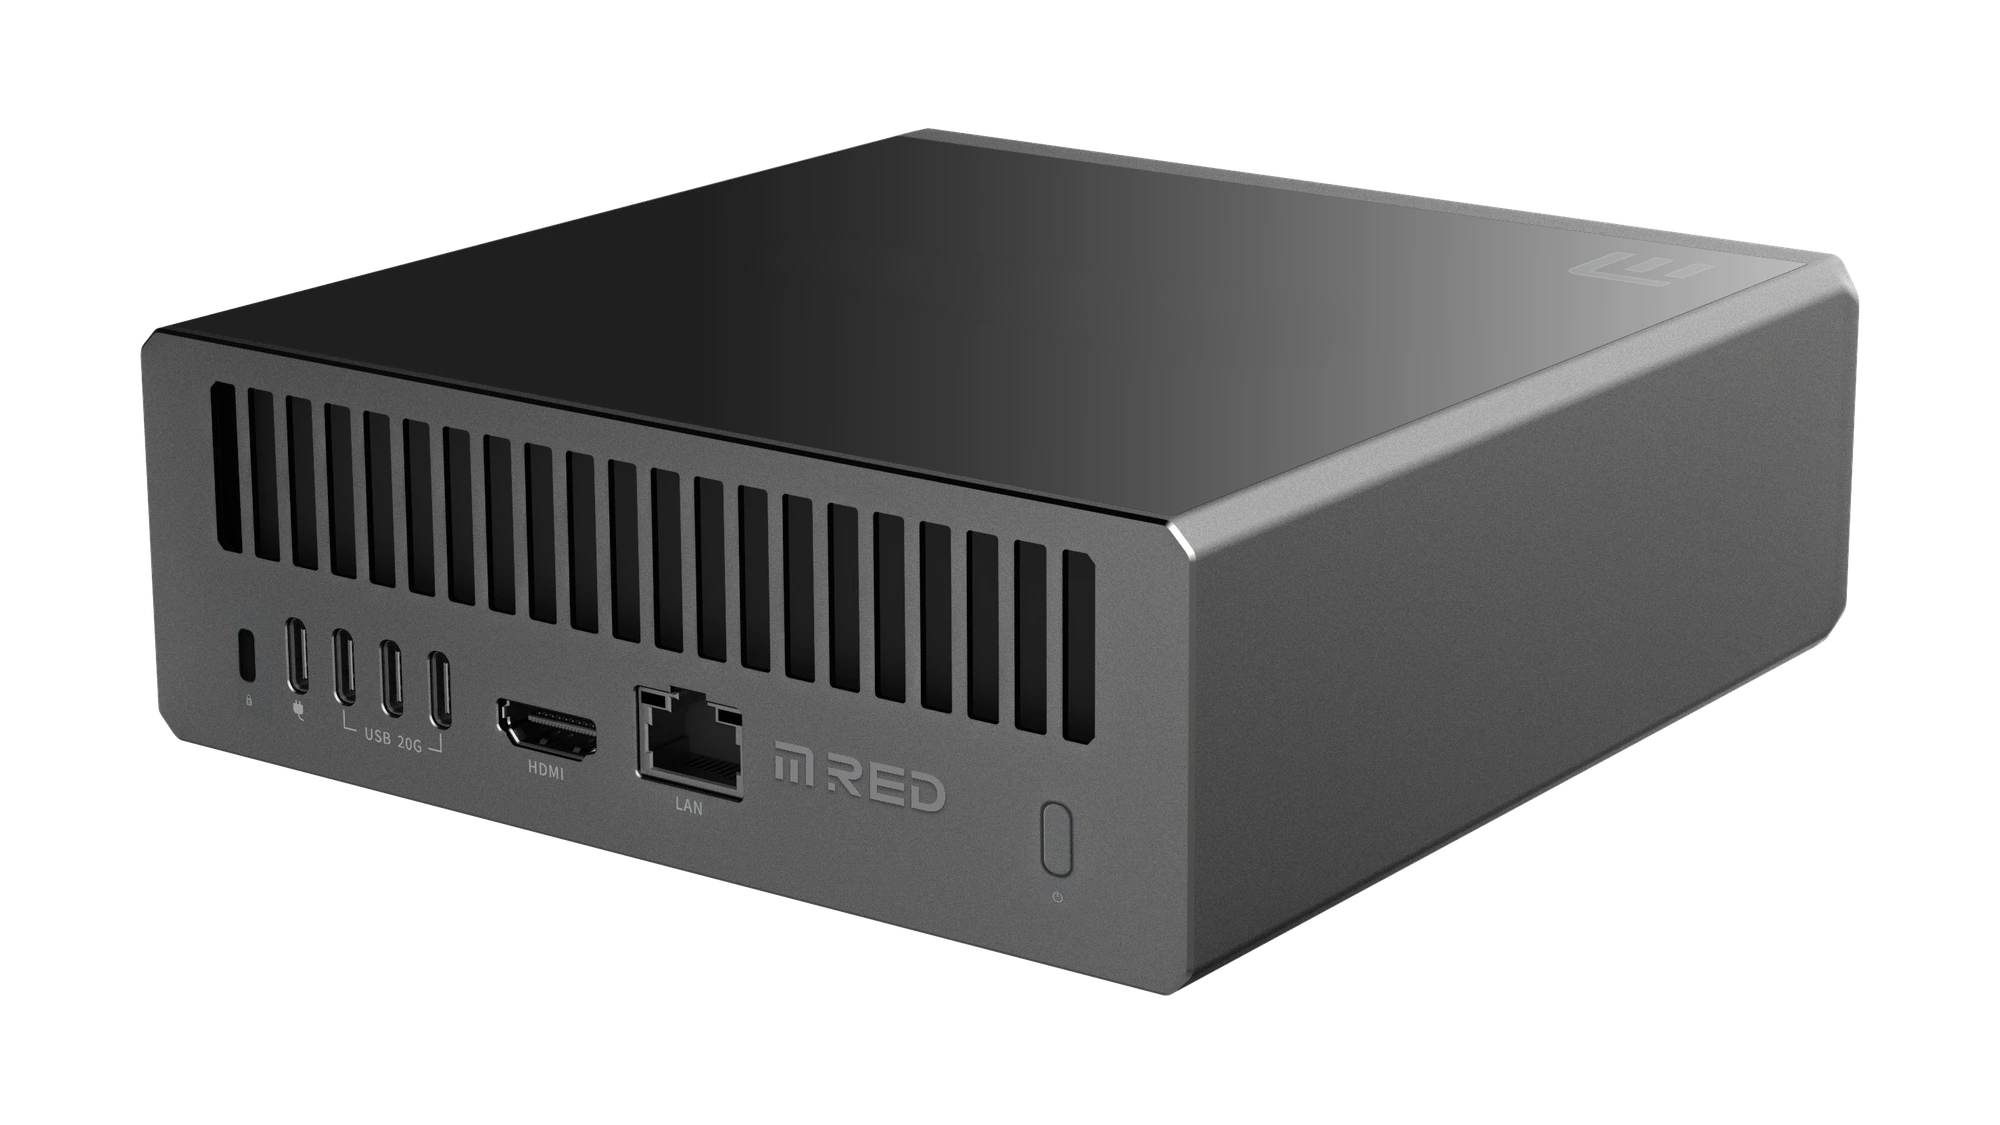
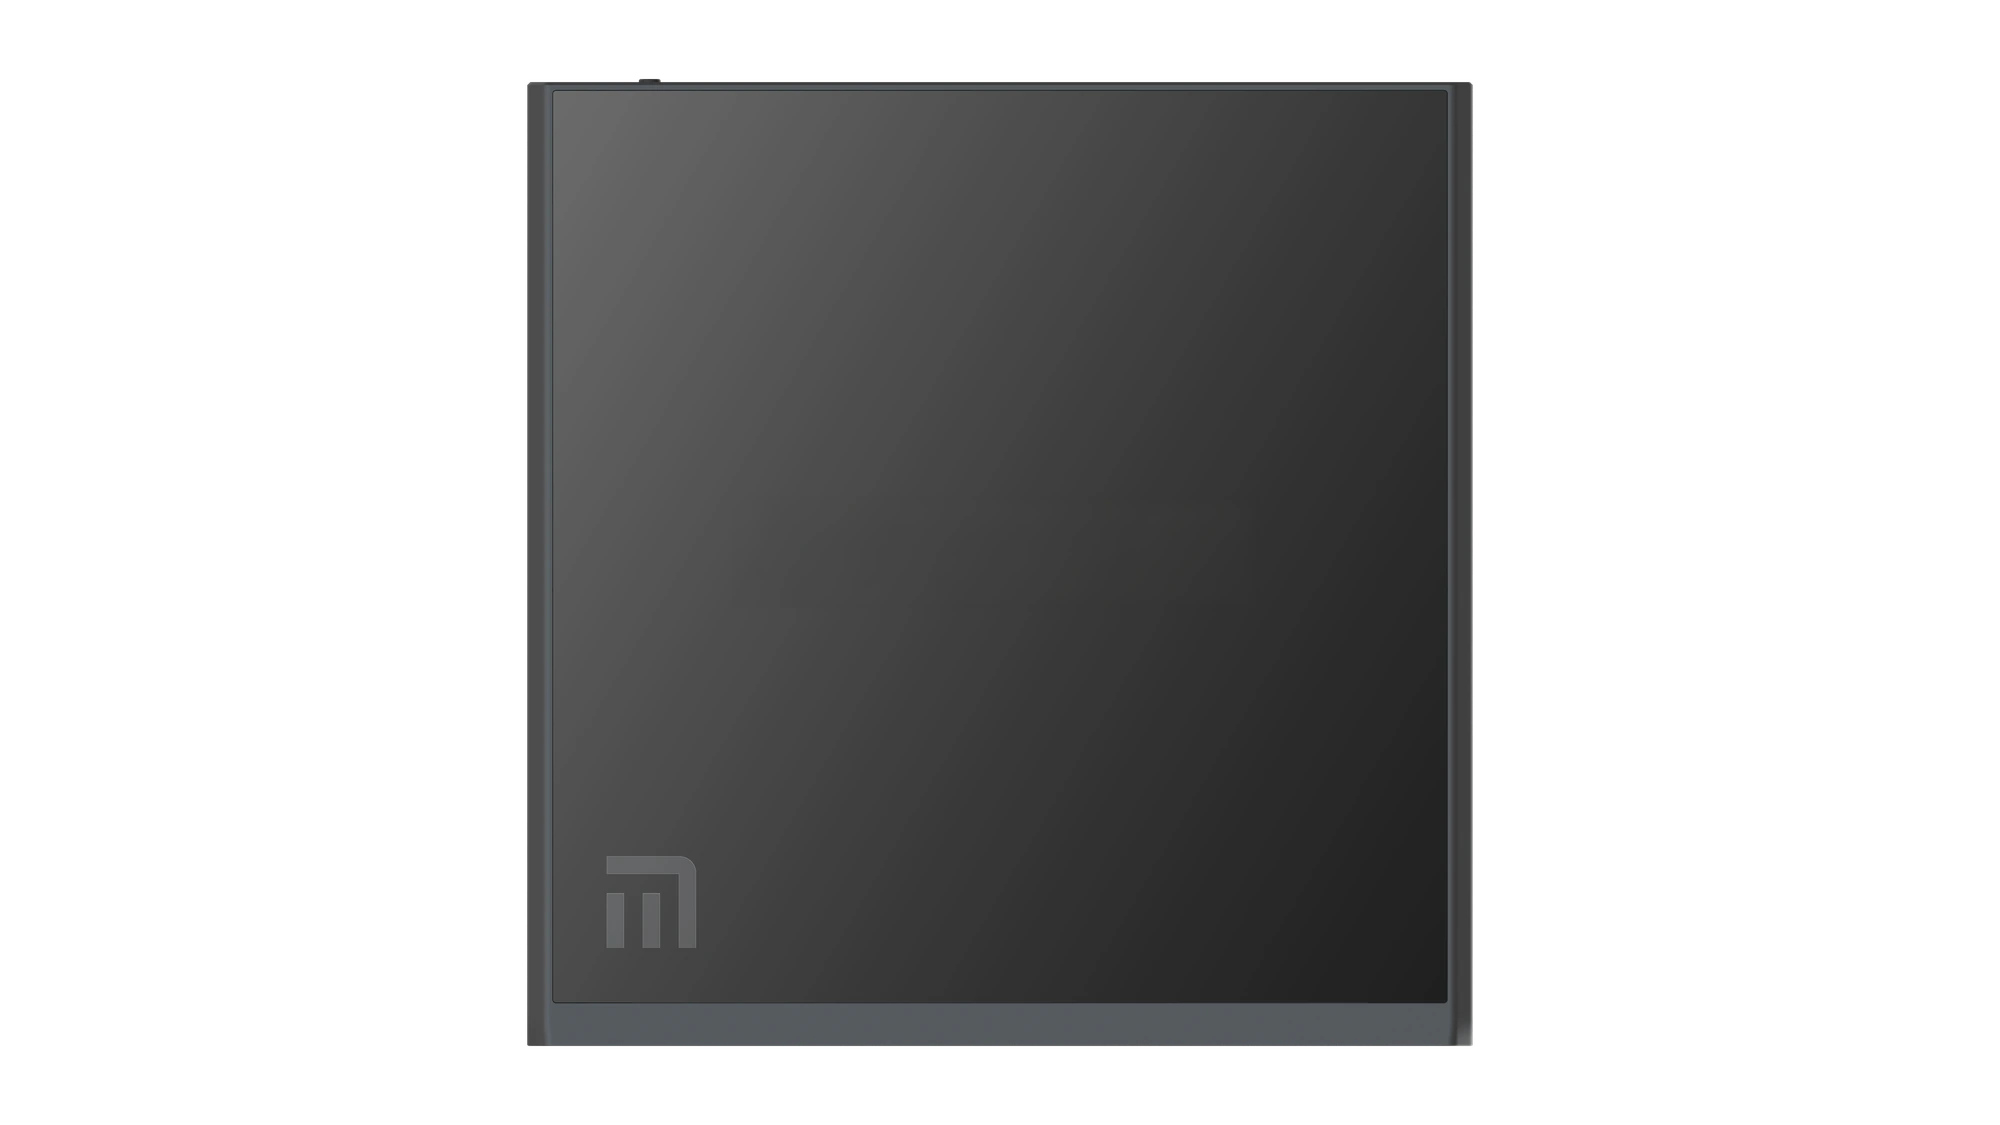
Más bajo que un cubo de Rubik.
15,5 cm de lado, 5,1 cm de alto, 1,42 kg. Carcasas de aluminio, parte superior de cristal con tratamiento antihuellas y un frontal de malla metálica con motivo de celdillas que ha dado nombre a la gama. Toda la conectividad está en la parte trasera.
Una torre gaming clásica ocupa unas treinta veces más espacio.
Configure su M.RED Hive.
Cuatro opciones. La memoria se decide en la compra: está soldada al chip.
Todo, en detalle.
- ProcesadorNVIDIA Grace, 20 núcleos Arm
- GráficosNVIDIA Blackwell RTX, 6.144 núcleos CUDA
- Rendimiento de IA1 petaflop en FP4 (1)
- Memoria64 o 128 GB LPDDR5X unificados9.400 MT/s, soldados
- Potencia140 W para el chip
- SistemaWindows 11 (versión 26H1)
- SeguridadChip TPM dedicado, ranura Nano
- Almacenamiento1 ranura M.2 2280 NVMe PCIe x4
- RedEthernet 10 GbE, Wi-Fi 7 y Bluetooth
- Salidas de vídeo1 × HDMI 2.1b, 3 × USB-C DisplayPort 1.4a
- AlimentaciónFuente USB-C de 240 W, de 100 a 240 V
- Dimensiones155 × 158 × 51 mm
- Peso1,42 kg
- MaterialesAluminio, malla metálica, cristal antihuellas
Fuentes: especificaciones de NVIDIA RTX Spark (versión de sobremesa) y ficha del fabricante.
- Potencia de IA Potencia de IAMil billones de operaciones por segundo en FP4 (1): en casa, lo que ayer exigía un servidor.
- 1 petaflop
- Memoria Memoria unificadaUn único depósito compartido por el procesador y la gráfica. Los modelos grandes caben enteros.
- 128 GB
- Procesador ProcesadorNVIDIA Grace, una arquitectura Arm procedente de los centros de datos.
- 20 núcleos
- Gráficos GráficosCUDA Blackwell, con Tensor Cores de 5.ª generación y RT Cores de 4.ª generación.
- 6144 núcleos
- Consumo ConsumoPara el chip, como máximo: menos que una sola tarjeta gráfica gaming de gama alta.
- 140 W
- Modelos en local Modelos en localDe parámetros como máximo, con 128 GB: modelos del tamaño de los que mueven los servicios en línea, en su escritorio (2).
- 200 mil M
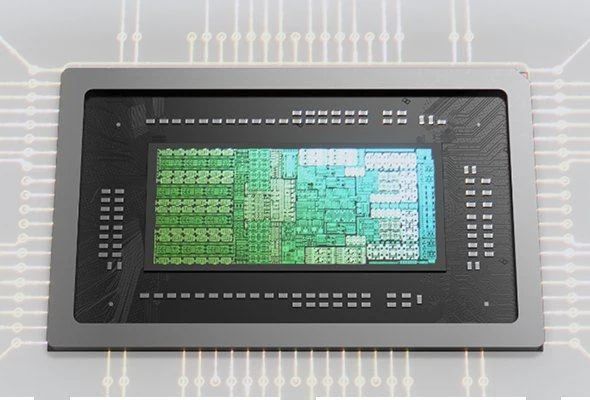
Dos cerebros, un solo chip.
En un PC clásico, el procesador y la tarjeta gráfica se comunican a través de la placa base. RTX Spark los reúne en el mismo chip, con la misma memoria.
Más memoria, modelos más grandes.
Un modelo de IA se mide en miles de millones de parámetros. Cuantos más tiene, más fino es su razonamiento y más memoria necesita. Elija un tamaño para ver lo que permite.
24GB32GB48GB64GB128GB
- Modelo local, como máximo
- 12 000 millones de parámetros25 000 millones de parámetros60 000 millones de parámetros90 000 millones de parámetros200 000 millones de parámetros
- Agentes
- En la nubeEn la nubeEn localEn localAvanzados, en local
- Escena 3D
- InteractivaInteractivaInteractivaHasta 45 GBHasta 90 GB
Referencias de NVIDIA para modelos cuantizados (2). La memoria se comparte con Windows y sus aplicaciones. La gama Hive se ofrece en Hive 64 y Hive 128.
8MM
Conversar a diarioPreguntas, reformulación, traducción rápida.
32MM
Redactar y resumirInformes, síntesis de documentos extensos.
70MM
Programar y analizarAsistente de desarrollo, análisis de datos.
120MM
Razonar como los modelos punterosHasta un millón de tokens de contexto: un expediente entero leído de una vez (3).
200MM
Varios agentes en paraleloEl modelo más grande mientras otros agentes trabajan.
Órdenes de magnitud. La capacidad real depende de la cuantización y de la longitud de contexto.
La misma IA, en dos sitios.
| IA en la nube | Características técnicas | M.RED Hive |
|---|---|---|
| Cada pregunta atraviesa Internet y espera su turno. | Respuesta | Inmediata, sin depender de la red. |
| Sus documentos salen hacia servidores de terceros. | Confidencialidad | Nada sale: sus datos se quedan en la sala. |
| Una suscripción por persona y, a veces, un precio por consulta. | Coste | Una compra, sin coste por consulta. |
| El modelo cambia cuando lo decide el proveedor. | Control | Usted elige el modelo y cuándo cambiarlo. |
| Si cae la red, se acabó el asistente. | Sin conexión | Sigue funcionando, incluso sin conexión. |
UniStudio también puede apoyarse en un modelo en línea cuando usted lo decida: la decisión es suya.
Lo que la IA local cambia en su día a día.
Imágenes, iluminación, ángulos de cámara: se prueba, se guarda, se vuelve a empezar, sin cola de espera.
Búsqueda de conceptos
Bocetos a mano o cola de espera en la nube: largos segundos, a veces minutos por imagen.
Las imágenes aparecen al ritmo de la idea. Se reilumina una escena o se cambia un fondo, sin límite de pruebas.
Edición de vídeo
Un nuevo ángulo o un efecto más significaba retocar imagen a imagen o un renderizado largo.
Los ángulos y los efectos se superponen en previsualización 4K. El 4:2:2 de las cámaras se decodifica por hardware.
Comparar, comprimir, medir: en la máquina, sin cuotas.
Ajustes en paralelo
Las cuotas de la nube obligaban a un ajuste cada vez, en varias sesiones.
Varias versiones se ejecutan a la vez, con mediciones en paralelo. El sobreajuste se ve al instante.
Cuantización de un modelo
Cada prueba de compresión obligaba a reenviar el modelo para medir la pérdida.
De FP16 a INT4 en local: se encuentra rápido el equilibrio entre velocidad y precisión.
Documentos de todo tipo, conciliados en local.
Conciliación de cuentas
ERP, existencias y extractos bancarios comparados línea a línea: errores de clasificación, pagos duplicados.
La IA lee los documentos, concilia los sistemas y aísla cada desviación.
Pruebas de resistencia
Divisas, materias primas y retrasos de pago a la vez: la hoja de cálculo no da más de sí.
Las simulaciones sobre el historial generan un informe listo para la dirección.
Los contratos no pasan por ningún servidor de terceros.
Revisión de contratos
Una cláusula ambigua o un límite de responsabilidad ausente requieren horas de un ojo experto.
Una comparación detallada señala las cláusulas de riesgo y las contradicciones.
Preparación de la vista
Anticipar los argumentos de la parte contraria dependía de la experiencia de los socios.
Simulaciones a partir de la jurisprudencia preparan a todo el equipo.
Los datos de salud se quedan en local.
Diagnóstico por imagen
Revisar TAC y resonancias ocupaba media jornada por informe, con la fatiga visual añadida.
Comparación asistida y reconstrucción 3D durante la consulta, como apoyo al médico.
Interacciones medicamentosas
Los prospectos se comprobaban uno a uno; las combinaciones poco frecuentes se escapaban.
El historial se cruza con el diagnóstico y salta una alerta al prescribir.
Una compra, no una suscripción por puesto.
Análisis entre departamentos
ERP, CRM y logística consolidados por cada departamento, con resultados que llegan tarde.
Las fuentes se reúnen en local y los bloqueos aparecen de inmediato.
Búsqueda en sus archivos
Años de procedimientos y proyectos dispersos, demasiado sensibles para la nube.
Una búsqueda sin conexión que responde citando sus propios documentos.
Escenarios ilustrativos. Los usos médicos y jurídicos siguen siendo responsabilidad del profesional.
Sus programas, acelerados por RTX.
Un procesador Arm con Windows 11
Las aplicaciones Arm y la pila CUDA funcionan de forma nativa. El software x86 pasa por la emulación de Windows: compruebe sus programas profesionales y los controladores de sus periféricos antes de comprar.
Antes de elegir.
¿Tiene otra pregunta? El soporte responde en 24 horas laborables.
¿Qué es, en la práctica, un agente de IA?
Un asistente responde. Un agente actúa: usted le da un objetivo («prepara la reunión de seguimiento del lunes a partir de mis correos»), él divide la tarea, abre los archivos que necesita, utiliza sus herramientas y le entrega el resultado. Con UniStudio, le pide su aprobación antes de cualquier acción arriesgada.
¿Funcionan mis programas en este PC?
Windows 11, las aplicaciones Arm y la pila CUDA funcionan de forma nativa. El software x86 pasa por la emulación integrada en Windows. Algunas utilidades antiguas, programas profesionales o controladores de periféricos pueden no funcionar: haga una lista antes de la compra, nuestro soporte le ayuda a comprobarlo.
¿64 o 128 GB?
64 GB bastan para un agente permanente y modelos de hasta 90 000 millones de parámetros. 128 GB abren la puerta a los modelos punteros y a varios agentes a la vez. La memoria va soldada: se elige en el momento de la compra.
¿Qué diferencia hay con un PC equipado con una RTX 5090?
Una torre con RTX 5090 ofrece más potencia bruta para juego y renderizado, con 32 GB de memoria gráfica. El RTX Spark SFF comparte hasta 128 GB entre procesador y GPU: permite ejecutar modelos de IA mucho más grandes, en una caja unas treinta veces más pequeña que una torre gaming, y 140 W para el chip.
¿Y el DGX Spark de NVIDIA?
DGX Spark funciona con Linux (DGX OS) y se dirige a los desarrolladores que entrenan y afinan modelos. El M.RED Hive funciona con Windows 11: conserva sus programas de creación, sus juegos y sus herramientas de oficina.
¿Hace ruido?
El chip está limitado a 140 W, lo que permite una refrigeración compacta y discreta. UniStudio ofrece modos de ventilación, del silencioso al turbo.
¿Hace falta conexión a Internet?
Para la instalación y la descarga de los modelos, sí. Después, los modelos locales y sus documentos funcionan sin conexión.
Notas
(1) Rendimiento de IA FP4 con dispersión, según NVIDIA, (2) referencias de tamaño de modelo por capacidad de memoria: página «Ayúdame a elegir» de NVIDIA (modelos cuantizados), (3) modelos de hasta 120 000 millones de parámetros con un contexto de un millón de tokens, según NVIDIA, (4) según la pantalla y el cable utilizados, (5) NVIDIA CUDA 12.1, TensorRT y NVFP4 compatibles, según las especificaciones NVIDIA RTX Spark, (6) según la página «Ayúdame a elegir» de NVIDIA (el rendimiento varía según el juego y los ajustes).
Fuentes. Especificaciones NVIDIA RTX Spark N1X (versión de sobremesa) y ficha del fabricante, noviembre de 2026. NVIDIA, RTX, GeForce, CUDA, DLSS, G-SYNC y Blackwell son marcas de NVIDIA Corporation. Imágenes de NVIDIA utilizadas con autorización. Los importes mostrados por el configurador se indican a título de ejemplo.